
AI
Text-to-SQLとは?
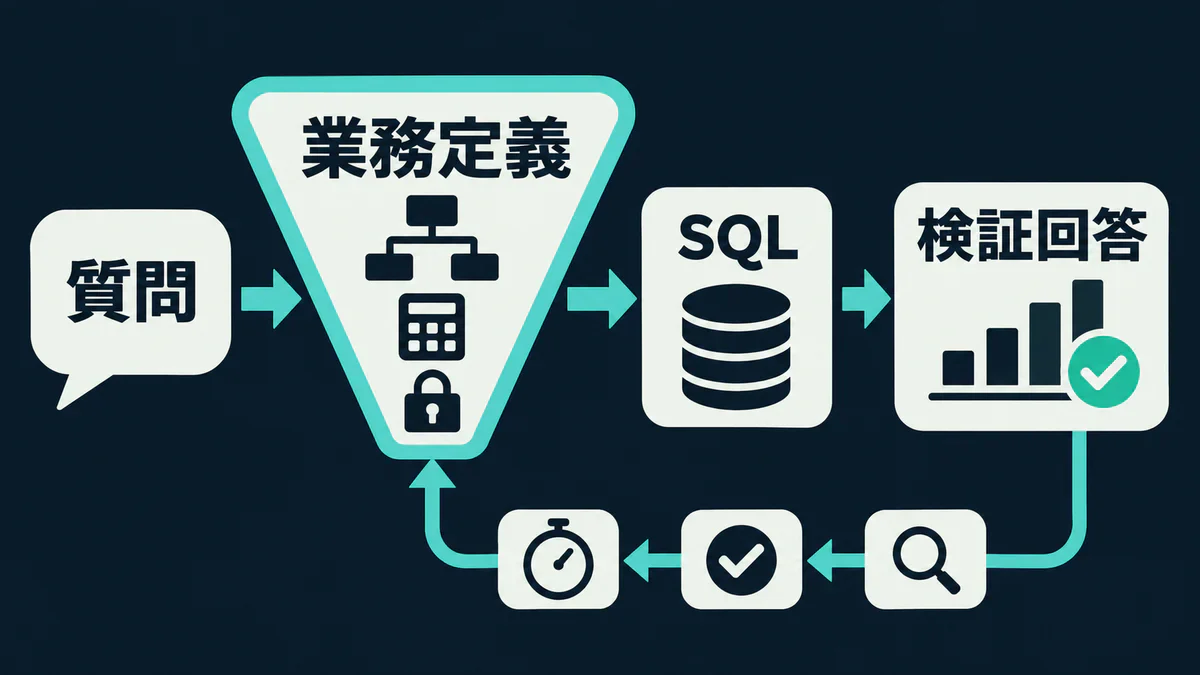
Text-to-SQLで自然な質問をSQLに変換し、社内データを集計する仕組みを解説します。実行できるSQLが誤答を返す原因、NVIDIA Auto Ontologyによる業務用語や計算式の整備、検証指標、権限管理など、導入前に確認すべき判断基準をまとめました。
はじめに
Text-to-SQLは、自然な言葉で書かれた質問をSQLに変換し、社内データから回答を得る仕組みです。 分析を依頼してから回答を得るまでの時間を短縮できます。
ただし、回答が速くても、経営判断に使えるとは限りません。 「売上」や「顧客」の定義が質問者とシステムでずれていれば、文法上は正しいSQLでも数字の意味を取り違えます。
この記事では、会議で追加集計が必要になるたびに、データ担当者へ依頼している事業責任者を読者として想定します。 質問から回答までの時間が短くなれば、会議中に仮説を確かめ、施策案の比較に時間を使えます。 一方、数字の意味を確認せずに回答だけを速くすると、事業責任者が誤った数字で判断する危険が増します。
Text-to-SQLの導入前に確認すべき点は、SQLの文法に限りません。 業務用語の定義をそろえ、既知の正解と利用者の権限に照らして回答を検証できるかどうかが、導入の判断基準になります。
Text-to-SQLは
Text-to-SQLは、「関東の法人顧客について、今期の平均購入額を前期と比べたい」といった質問からSQLを作ります。 生成されるSQLには、参照する表、期間、条件、集計方法が含まれます。 そのため、定型レポートにない追加質問でも、担当者自身が答えを探せます。
自然な言葉をSQLへ変換する処理がText-to-SQLです。 営業実績の切り分け、施策前後の利用状況の比較、問い合わせ傾向の確認などに利用できます。
導入当初から、人による確認をなくす必要はありません。 生成されたSQL案をデータ担当者が確認する運用でも、ゼロからSQLを書く時間は減らせます。
事業責任者が確認すべき指標は、自動化率だけではありません。 質問してから検証済みの回答を得るまでの時間も確認します。
Text-to-SQLの
Text-to-SQLでは、SQLがエラーなく動いても、質問者が意図した指標や対象を選んでいるとは限りません。
Text-to-SQLの精度を左右する要因には、SQLの文法だけでなく、社内用語、期間、集計単位を実データへ正しく対応させられるかどうかも含まれます。 たとえば「売上」は、受注額、出荷額、請求額、返品控除後の金額のどれを指すかで結果が変わります。 「顧客数」も、契約数で数えるか、法人単位で重複を除くかによって数字が変わります。
| 質問の表現 | 決めておく定義 | ずれた場合の影響 |
|---|---|---|
| 今月 | 暦月か締め日基準か | 比較期間がずれる |
| 売上 | 受注、出荷、請求のどれか | 業績評価が変わる |
| 顧客数 | 契約、店舗、法人のどの単位か | 重複集計が起きる |
| 新規顧客 | 初回購入か初回契約か | 獲得施策の評価を誤る |
同じ質問でも、採用する定義によって答えは変わります。 SQLが実行できたことだけを確認しても、担当者は定義のずれを検出できません。
実務に近い課題を扱うBIRDは、12,751組の質問とSQL、95のデータベース、37分野を収録し、汚れたデータ、外部知識、実行効率を課題に挙げています。BIRDのNeurIPS 2023論文↗ ただし、この数字は特定製品の導入効果を表すものではありません。 評価時には、実行可能なSQLと業務上正しい答えを分けて扱う必要があります。
NVIDIA Auto Ontologyに
モデルに社内で使う言葉の意味を伝えるには、表名や列名だけでは不十分です。 表名や列名からは、「売上」がどの金額を指すのかを特定できないためです。
この不足を補う仕組みの一つが、NVIDIA Auto Ontologyです。 表や列に加え、業務用語、認証済みの計算式、表同士の関係をText-to-SQLへ渡します。 これにより、モデルが推測する範囲を減らし、担当者が回答の根拠を確認できるようにします。
データの保存形式と業務上の意味を対応させる層を、セマンティックレイヤーと呼びます。 公式READMEでは、企業のメタデータから定義案を作り、人が認証した用語、指標、関係を使って質問を処理すると説明しています。 実装や対応範囲を確認する際は、公式READMEが中心資料になります。
精度を補う方法によって、対応できる問題は異なります。
| 打ち手 | 主に補うもの | 限界 |
|---|---|---|
| プロンプト改善 | 出力形式、質問の分解、禁止事項 | 社内定義そのものは作れない |
| RAG | 規程や用語集など関連文書の検索 | 説明と列や計算式の対応が別途必要 |
| セマンティックレイヤー | 用語、列、計算式、結合関係の対応 | 定義の確認と更新を人が担う |
| SQLの実行検証 | 文法、参照先、実行結果 | 指標の意味が正しいかは別途確認が必要 |
プロンプトを改善すると、出力形式や質問の分解方法を調整できますが、社内定義そのものは作れません。 RAGで規程や用語集を検索する場合も、説明を列や計算式へ対応させる作業は残ります。 セマンティックレイヤーはこの対応を担いますが、担当者による定義の確認と更新が必要です。
ただし、Auto Ontologyは「登録すれば必ず正解する仕組み」ではありません。 既存の意味モデルを補完する位置付けであり、元データの欠損や更新遅延は別に管理します。
導入効果は
対象業務を絞ってText-to-SQLを導入すると、事業責任者から分析担当者への抽出依頼を減らせます。 事業責任者は追加質問をその場で試しやすくなり、分析担当者は指標の定義や例外処理へ時間を使えます。
ただし、回答が速くなっても、人による確認作業が増えれば総所要時間は短くなりません。 効果を測る際は、回答速度、検証工数、回答を判断に使えた割合を記録します。
小規模検証では、次の指標を導入前後で比べます。
- 質問から検証済み回答までの時間
- 既知の正解と一致した質問の割合
- 人がSQLや結果を確認した時間
- 答えられない質問を適切に保留した割合
- 権限外の表や列を参照した件数
回答速度だけでは、確認にかかった負担を把握できません。 正答率だけを見ても、答えるべきでない質問を保留できたかは分かりません。
試作版と現行業務を同じ指標で比較する進め方は、atypicalのAIエージェント診断とPoC開発でも採用しています。 製品を選ぶ前に、毎月繰り返す集計を一つ選び、現在の所要時間と正解を記録します。 この記録があれば、試作版との差を基に投資を判断できます。
Text-to-SQL導入前に
Text-to-SQLの精度を測るには、正解を決め、その根拠を説明できる担当者が必要です。 導入可否は、その担当者を置けるか、検証用の質問を用意できるか、アクセスを制御できるかで判断します。 これらを用意できない業務では、モデルを高性能にしても、本番運用の責任者が回答の正しさを判断できません。
検証は次の順で進めると、担当者が誤答の原因を切り分けやすくなります。
- 一つの業務領域と、実際に使う質問を決める
- 売上や顧客など、解釈が分かれる用語と計算式を洗い出す
- 既存の集計で正解が分かっている質問を用意する
- 結果、生成SQL、参照表、拒否判断を記録する
- 回答時間、正答率、確認工数を現行業務と比べる
この記録を使うと、担当者は誤答の原因が用語の定義、SQL生成、参照先、拒否判断のどこにあるかを確認できます。
本番運用では、精度と併せて権限も確認します。 Auto Ontologyはロールに基づくアクセス制御を備え、利用者の権限をAPIやMCPからの呼び出しにも適用する仕様です。NVIDIA Auto Ontologyの認証と権限管理↗
ただし、接続先ごとにスキーマや表の範囲を制限できても、認証情報の保管方法やネットワーク構成は自社で審査します。NVIDIA Auto Ontologyの接続と認証情報の仕様↗ 担当者は、「権限を設定できれば十分」と判断せず、その設定が自社の運用要件を満たすかまで確認します。
最初の対象には、正解を判定しやすく、誤りが顧客や会計処理へ直接反映されない社内分析が向いています。 契約、会計、顧客対応を自動で変える用途では、人による承認を残すのが妥当です。
まとめ
Text-to-SQLを使うと、利用者は自然な質問から社内データを集計でき、分析依頼の待ち時間を減らせます。 ただし、SQLが動いたことだけを根拠に、会議で使える数字だと判断することはできません。
Text-to-SQLの導入時は、業務用語と計算式を定義し、既知の正解との一致、確認工数、権限違反の有無を検証します。 定義と正解例を用意できる組織は、一つの定例集計から小規模検証を始められます。
定義と正解例を用意できていない場合は、製品を選ぶ前に、会議で使う指標の定義と、その正しさを説明する責任者を決める必要があります。
参考文献
- GitHub - NVIDIA/auto-ontology: Auto Ontology↗
- Can LLM Already Serve as A Database Interface? A BIg Bench for Large-Scale Database Grounded Text-to-SQLs↗
- Authentication, SSO, and API tokens - NVIDIA Auto Ontology↗
- Connections and credential storage - NVIDIA Auto Ontology↗
- 札幌のAIエージェント開発会社 - 株式会社atypical