
AI
LLM評価
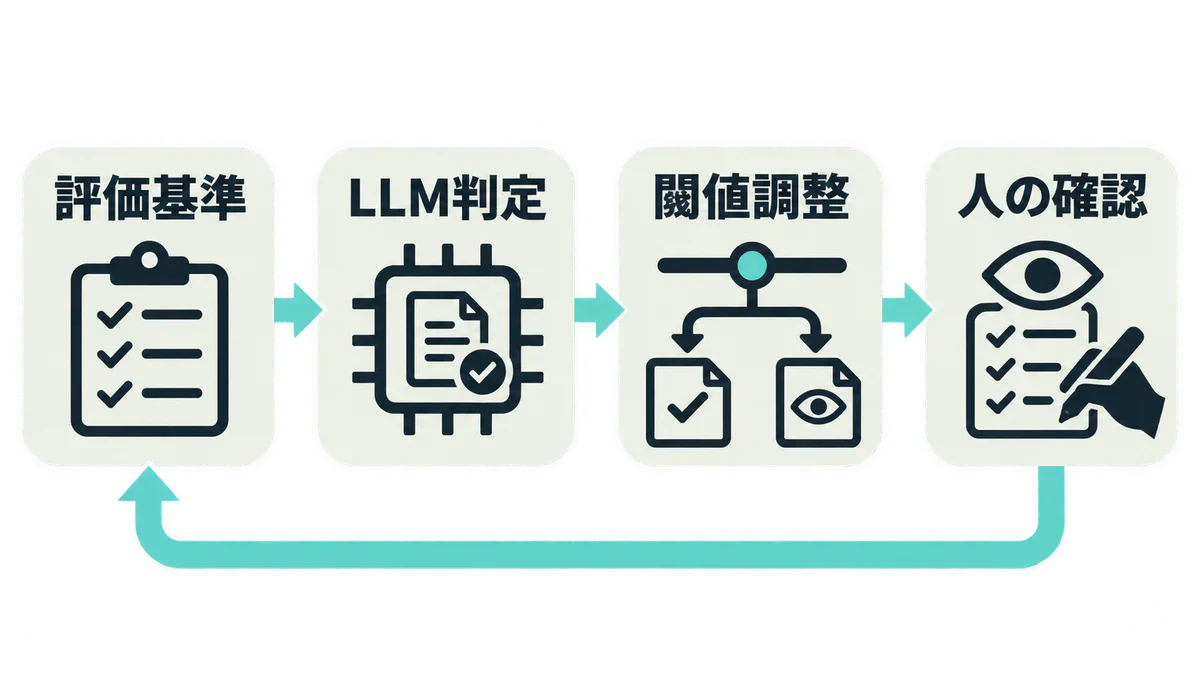
LLM評価を自動化し、生成AIの回答品質を継続的に確かめる方法を解説します。人による評価との使い分け、誤検知と見逃しによる損失を踏まえた閾値調整、判定モデルの比較、導入後も信頼性を保つ運用手順が分かります。モデルや開発ツールに詳しくない事業責任者にも役立つ内容です。
はじめに
生成AIを業務へ導入したあとは、回答品質の変化を継続的に確かめます。 担当者の感想だけでは、プロンプトやモデルを変更した効果を比較できません。 すべての回答を人が読めば確認できますが、利用量が増えるほど時間がかかり、改善の頻度も下がります。
そこで、別の大規模言語モデル(LLM)に回答を判定させ、変更前後の品質を同じ基準で比べる方法がLLM評価の自動化です。 問い合わせ対応や文書作成など、人による全件確認が難しい業務に向いています。
ただし、「自動化率が高いほどよい」とは限りません。 事業責任者は、誤検知と見逃しによって生じる損失を確認します。
人が決めた採点基準に沿って、別のLLMが回答を分類し、採点する仕組みをLLM-as-a-Judgeと呼びます。 担当者は「LLM-as-a-Judge」を使って、人が詳しく確認する回答を絞り込み、変更前後の結果を比較します。 最終的な判断までLLMに任せる仕組みではありません。
LLM評価の
LLM評価の自動化により、担当者は大量の回答を同じ基準で繰り返し検査し、品質の低下を早い段階で見つけられます。 経営者や事業責任者も、AIの導入効果を担当者の感想ではなく、変更前後の記録から判断できます。
社内問い合わせAIを評価する場合は、たとえば次の項目を分けて判定します。
- 質問に答えているか
- 社内規程と矛盾していないか
- 根拠となる文書を示しているか
- 不明な場合に担当窓口へ引き継いでいるか
総合点だけでは、回答が悪化した原因を特定できません。 正確さ、根拠、引き継ぎを個別に判定すれば、担当者は修正すべき箇所を絞れます。
評価要素を個別に判定する方法は、AISIのAIセーフティ評価に関する実践ガイド↗にも示されています。 同ガイドは、明確な評価基準と具体例を用意し、変更のたびに評価する継続運用を推奨しています。
自動評価によって短縮できるのは、検査にかかる時間です。 担当者が品質低下をリリース前に検知できれば、顧客対応の手戻りや誤案内のリスクも抑えられます。 事業責任者は評価結果と変更履歴を照合し、どの変更を残すか判断できます。
判定結果は
LLMによる判定を、そのまま正解として扱うことはできません。 導入担当者は実際の業務データを使い、判定結果が業務に詳しい社内担当者の判断とどの程度一致するかを確かめます。
判定結果には、回答の提示順や長さが影響する場合があります。 LLMには、先に表示された回答や長い回答を選びやすい傾向があるためです。 AISIのガイドは、回答の提示順を入れ替えること、簡潔な回答も評価できる基準を設けること、人の評価と比較することを対策として挙げています。 OpenAIのEvaluation best practices↗は、自動採点を人の意見に合わせて調整するよう勧めています。 評価方法には、比較、分類、明確な基準に沿った採点を使います。
導入前には、業務担当者が正解を付けた回答例を用意します。 判定モデルの誤り方を調べるには、良い回答だけでなく、次のような失敗例も必要です。
- 正しそうに見えるが、規程と異なる回答
- 必要な注意事項が一つ抜けた回答
- 結論は正しいが、根拠が誤っている回答
- 判断できない質問に無理に答えた回答
候補となる判定モデルは、同じデータを使って比較します。 担当者は、人の判断に近いモデルを選ぶために、モデル名や総合点だけでなく、どの回答をどのように間違えたかも確認します。
同じ種類の失敗が続く場合は、「判定モデルを変えれば解消する」とは限りません。 その場合は、担当者が採点基準や例示も修正します。
合否を
合否を分ける閾値は、同じ判定モデルを使っても用途ごとに変わります。 担当者は0.5などの初期値で固定せず、誤検知と見逃しのどちらが事業に大きな損失を与えるかを基準に決めます。
二つの誤りを業務上の影響に置き換えると、判断しやすくなります。
| 誤り | 業務で起きること | 重く見る業務の例 |
|---|---|---|
| 誤検知 | 問題のない回答を止め、人の確認を増やす | 大量の下書き作成、社内検索 |
| 見逃し | 問題のある回答を通し、顧客や社員へ示す | 契約、規程、安全に関わる案内 |
閾値の候補を比較する際は、二つの指標を使います。 問題ありと判定した回答のうち、本当に問題があった割合が適合率です。 実際に問題があった回答のうち、検出できた割合が再現率です。 閾値を動かすと両者の関係も変わるため、担当者は正解を付けたデータで候補値を比較します。 scikit-learnのPrecision-Recall解説↗
適合率と再現率を一つにまとめる指標がF1スコアです。 この指標は、誤検知と見逃しを同程度の誤りとして扱います。
しかし、法務回答の見逃しと社内文書の誤検知では、事業に与える損失が異なります。 そのため、担当者はF1スコアの最大値だけで最終的な閾値を決められません。 追加確認にかかる時間、誤案内の影響、公開前に人が止められるかも判断材料に含めます。
判定モデルが出す0.8というスコアも、80%の確率で正しいとは限りません。 事業責任者がスコアを確率として予算配分や人員配置に使う場合は、同じスコア帯で実際に正しい回答の割合を確かめます。 この作業を確率校正と呼びます。 scikit-learnの確率校正ガイド↗
LLM評価の
LLM評価の自動化は、影響を限定でき、担当者が正解の理由を説明できる一つの業務から始めます。 業務の良否を説明する基準がなければ、判定モデルや閾値を選んでも結果を比較できません。
導入前に用意するのは、評価基準と人が採点したデータです。 その後で、判定モデル、閾値、運用方法を選びます。
- 評価する業務を一つ選ぶ
問い合わせ回答、議事録、商品説明など、良否を担当者が説明できる業務に絞ります。 - 失敗したときの損失を整理する
事業責任者が、誤検知で増える確認時間と、見逃しによる顧客への影響や再作業を分けます。 - 業務担当者が回答例を採点する
通常例、境界例、重大な失敗例を含め、判定理由も残します。 - 候補モデルを同じデータで比較する
導入担当者が、人の判断との一致、誤り方、処理時間、利用料金を並べます。 - 閾値と人の確認範囲を決める
高リスクの回答は人が確認し、低リスクの回答から自動化の範囲を広げます。 - 変更のたびに再評価する
モデル、プロンプト、参照データを変えた際に同じ方法で評価し、担当者が新しい失敗例を追加します。
この手順によって、担当者は改善案を同じ条件で比べられるようになります。 事業責任者は、品質、費用、処理時間の変化を見て採用する案を決めます。 AIの構成を現行業務と比べて効果を確かめたい場合は、atypicalのAIエージェント開発支援で、診断からPoC、継続改善までの進め方を確認できます。
まとめ
LLM評価の自動化では、人が決めた基準を繰り返し適用し、人が詳しく確認する回答を絞ります。 担当者はその結果を使い、変更前後の品質を比較します。 「回答の全件確認をすぐに無人化できる」という方法ではありません。
導入前には、業務担当者が良い回答と悪い回答の違いを説明できるか確認します。 事業責任者は、誤検知と見逃しによる損失を分け、高リスクの判断を人が確認できる運用にします。
この条件を満たす業務では、まず少数の回答例を人が採点し、判定モデルとの不一致を調べます。 不一致の記録と変更前後の評価があれば、担当者は回答の品質が良くなったかを比較できます。 事業責任者はその結果から、自動化の範囲を広げるか、人が確認する範囲を広げるかを決めます。