
AI
Jevboxとは?
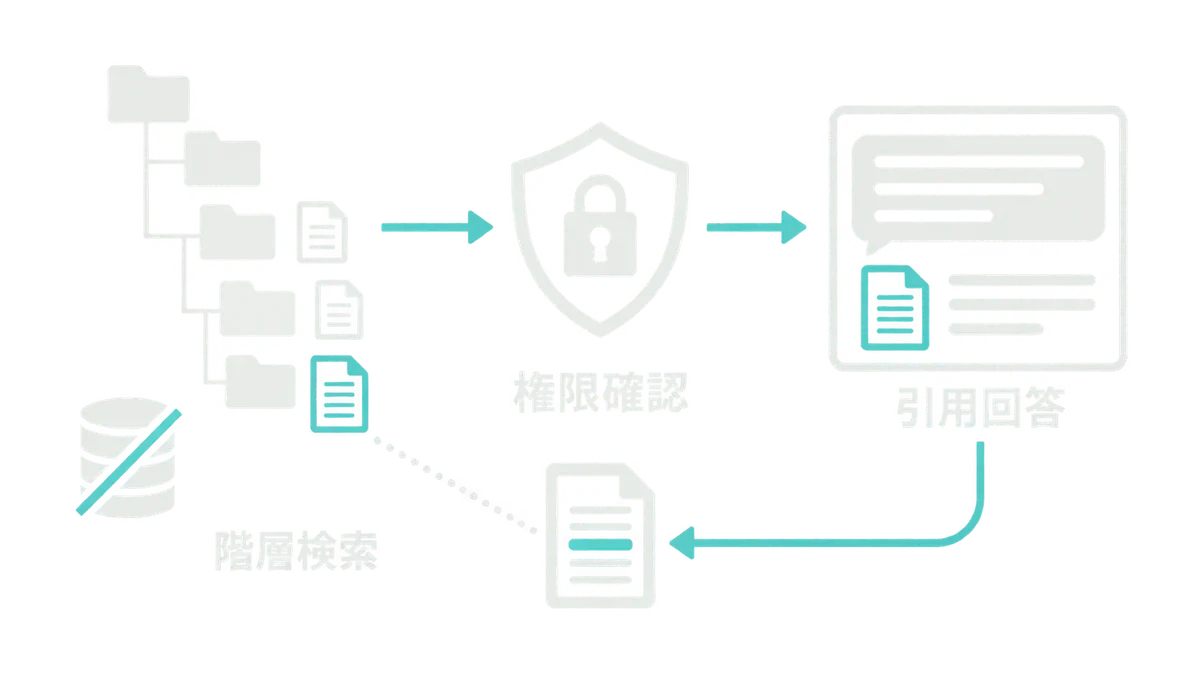
Jevboxの階層検索、引用付き回答、アクセス権限、MCP連携を、一般的なベクトル検索型RAGとの違いから解説します。セルフホストに必要な構成や外部サービス、試験導入で確認すべき費用、検索品質、セキュリティの判断基準も紹介します。運用責任者向けの入門記事です。
はじめに
ファイルの保存場所が分かっていても、回答の根拠が何ページにあるか分からなければ、担当者は文書を開いて探し直さなければなりません。 規程、製品資料、議事録が増えるほど、この確認に時間がかかります。
生成AIに文書を渡せば、文書に関する回答を得られます。 ただし、その回答がどの記述に基づくのか、閲覧権限の異なる資料が混ざっていないかは、別途確認が必要です。
この課題に対応する文書管理システムが、Jevboxです。 Jevboxは、社内文書をフォルダや見出しの階層から検索し、根拠となる箇所を添えて回答します。 セルフホストが可能で、利用者は回答から原文へ移動できます。 検索結果には閲覧権限が反映されます。
Jevboxは、既存の文書構造と閲覧権限を生かした検索を試したい組織に適しています。 導入時には検索精度に加え、外部AIサービスの費用、認証要件、バックアップを含む運用体制も検討しなければなりません。
この記事では、社内文書検索を検討している事業責任者に向けて、Jevboxの機能と導入時の確認事項を説明します。 技術選定の前に、文書を探す時間、回答を確認する手間、情報漏えいの可能性をどこまで減らしたいかを決めておくと、試験導入の目的が明確になります。
Jevboxは
Jevboxは、文書の保存と共有に加え、複数文書への質問、回答根拠の確認、権限に応じた検索、文書の自動整理に対応します。 利用者は回答から元のページや該当箇所へ戻り、原文を確認できます。 業務で回答を使うには、この確認手段が欠かせません。
主な機能は次のとおりです。
- PDF、Word、Excel、PowerPointなどを保管し、文書内の見出しやページ範囲を表示する
- 質問に関連する原文を探し、その箇所を根拠に回答する
- 引用表示から元文書を開き、該当する位置を確認する
- 非公開、組織共有、継承された権限を検索結果にも反映する
- 文書の内容を基に、既存フォルダへの分類候補を判断する
- 読み取り専用のAPIとMCPサーバーを介して、外部のAIクライアントから検索する
公式READMEには、対応形式、ローカル実行、権限管理、MCP連携、ライセンスに関する情報がまとまっています。 JevboxのソースコードはMITライセンスですが、アイコンなど一部の資産には別の条件があります。
Jevboxを使えば、担当者が回答の根拠を探し直す時間を減らし、問い合わせ対応や社内確認の手順をそろえられる可能性があります。 短縮できる時間は、文書の構成や質問内容によって変わります。 自社文書を使い、導入前後の所要時間を比較します。
Jevboxは
文書検索に生成AIを組み合わせる方法の一つが、検索拡張生成(RAG)です。 一般的なベクトル検索型RAGはベクトルDBを使いますが、JevboxはベクトルDBを必須としません。
Jevboxは、フォルダ、文書、節の順に階層をたどって候補を絞ります。 次に、候補となった原文が質問への回答にどれほど役立つかを評価し、回答モデルへ渡します。 一般的なベクトル検索型RAGは、文章を数値化し、質問と意味の近い断片を探す方式です。 両者では、検索候補を選ぶ手掛かりが異なります。
導入判断に関係する違いは次のとおりです。
| 比較項目 | Jevbox | 一般的なベクトル検索型RAG |
|---|---|---|
| 主な探索手掛かり | フォルダ名、文書名、見出し、節の構造、原文 | 質問と文書断片の意味的な近さ |
| ベクトルDB | 不要 | 通常は必要 |
| 文書構造の扱い | 階層を検索経路として使う | 分割方法や付加情報の設計に依存する |
| 根拠確認 | 文書、節、ページ、原文ブロックを引用に結び付ける | 実装によって異なる |
| 注意点 | 見出しやフォルダ構成が候補選択に影響する | 分割単位や埋め込みモデルが検索結果に影響する |
Jevboxの検索アーキテクチャ↗によると、Jevboxは検索時に利用者が閲覧できる階層を組み立て、必要になった文書の節だけを読み込みます。 その後、候補となった原文の有用度を評価します。 最終結果には、文書名、節、ページ範囲、原文位置が付きます。
ベクトルDBが不要でも、AI関連の外部サービスまで不要になるわけではありません。 Jevboxの検索にはTypeSafeまたはCloudflare Clefが必要で、回答文の生成には別のチャットモデルを設定します。 費用を比較するときは、データベース代に加え、文書解析、候補選択、回答生成を含む総額を算出します。
権限管理と
業務で文書検索を使うには、検索結果へのアクセス権限管理が必要です。 閲覧権限のない文書が検索結果に混ざれば、担当者はその結果を利用できません。 回答の根拠を確認できなければ、回答だけを基に判断することも難しくなります。
Jevboxは文書の閲覧権限を確認し、回答から原文へ戻る手段を残します。 契約条件や社内規程など、回答内容と閲覧範囲の両方を確かめる業務で使える仕組みです。
権限判定にはSpiceDBが使われます。 公式のセキュリティ境界に関する説明↗では、一覧、原本、解析済み内容、検索結果、引用、会話までが認可の対象です。 Jevboxは、検索経路の途中と結果を返す前に権限を再確認します。 利用者が情報への権限を失うと、その情報に依存する会話も閲覧できなくなります。
引用が付いていても、回答が正しいとは限りません。 公式文書にも、生成結果は誤る可能性があり、利用者が引用元と照合する必要があると記載されています。
そこで、組織は質問の種類ごとに確認者を決めます。
| 質問の例 | 想定する確認者 | 確認すべき点 |
|---|---|---|
| 製品仕様への問い合わせ | 商品または開発担当者 | 現行版の資料か、条件や例外が欠けていないか |
| 契約条件の確認 | 法務または契約担当者 | 引用箇所だけで判断できるか、別条項との関係はないか |
| 社内手続きの案内 | 制度の主管部門 | 改定日、対象者、承認経路が正しいか |
引用は、確認作業をなくす機能ではありません。 担当者が確認すべき原文を短時間で特定するための機能です。 この前提に立ち、回答を自動送信する範囲と、人の承認を必要とする条件を決めます。
セルフホストでは
セルフホストでは、組織が自社側でデータを管理し、システムを継続して動かす責任も負います。 Jevboxは、非技術部門だけで導入と運用を完結できるSaaSではありません。 開発担当者または運用委託先を含めて検討する製品です。
手元で試すには、Node.js、pnpm、Dockerが必要です。 本番運用では、PostgreSQL、SpiceDB、オブジェクトストレージ、メール送信環境なども担当者が管理します。
試験環境は、おおむね次の順序で準備します。
- リポジトリを取得し、指定されたNode.js、pnpm、Dockerの環境を用意する
- 依存関係を導入し、初期設定を作成する
- PostgreSQLとSpiceDBを起動する
- Jevboxを起動し、組織を作成する
- 文書解析、階層検索、回答生成に使う接続先と認証情報を設定する
- 権限の異なる複数アカウントで、アップロード、検索、引用、権限剥奪を検証する
アプリを起動した後も、本番運用に向けた準備が必要です。 本番向けの公式デプロイ手順↗では、コンテナ、Kubernetes、AWS、Renderを扱っています。
本番構成には、アプリ用とSpiceDB用のデータベース、非公開のS3互換ストレージ、TLS、SMTP、暗号鍵などが含まれます。 組織は、鍵の保管、障害復旧、監視、更新手順の担当者を決めなければなりません。
MCPは、対応するAIクライアントからJevboxの検索や回答機能を呼び出すための接続方法です。 MCP連携そのものが検索品質を改善するわけではありません。
試験時には、連携先にも同じ権限が反映されるか、担当者がAPIキーやOAuthを失効させられるかを確認します。 接続だけでなく、権限変更や認証情報の失効も検証対象に含めます。
自社文書での
Jevboxは、見出しのある文書を継続的に蓄積し、利用者ごとに閲覧範囲が異なる組織に向いています。 次のような状況なら、試験導入の対象になります。
- 規程、手順書、製品資料など、構造化された長い文書が多い
- 回答だけでなく、根拠となるページを担当者が確認したい
- 部門、案件、役割によって閲覧範囲が変わる
- 文書検索をWeb画面とAIクライアントの両方から使いたい
- 自社環境でデータと権限基盤を管理できる
画像だけの資料が多い場合や、フォルダと見出しがほとんどない場合は、期待する検索品質を得られるか検証しなければなりません。 Jevboxは文書の階層を検索に使うため、既存のフォルダ構成や見出しが候補選択に影響します。 検索結果を人が確認できない用途にも、慎重な判断が必要です。
運用要件も確認します。 公式資料によると、SSO、MFA、マルウェア検査、保持ポリシー、自動バックアップ、複数Webレプリカ運用は、標準機能として有効になっていません。 これらを必須とする組織は、追加実装や周辺サービスを含めて費用と運用方法を評価します。
試験導入の段階で、全社の文書を移行する必要はありません。 事業責任者は問い合わせが多い業務を一つ選び、次の項目を現行の手順と比較します。
- 回答と根拠の確認にかかった時間
- 正しい文書と該当箇所へ到達できた割合
- 閲覧権限を変更した後の検索結果
- 文書の追加や改定に必要な作業時間
- 解析、判断モデル、回答モデル、基盤運用を合わせた費用
- 誤回答時の修正手順と責任者
採否は、機能数だけでは決められません。 担当者が対象文書と該当箇所を検索できるか、権限の変更が検索結果に反映されるか、組織が運用費を継続して負担できるかを測って判断します。
まとめ
Jevboxは、文書の階層をたどる検索、原文へ戻れる引用、SpiceDBを使った権限確認を、一つの文書管理環境で提供します。 ベクトルDBなしで検索できますが、組織は文書解析、判断モデル、回答モデル、データベースなどを用意して運用します。
導入を判断する担当者は、権限差のある代表的な文書を少量選びます。 その文書を使って検索時間、根拠の正確さ、権限変更後の動作、月間費用を測れば、限定した業務で使うか、自社要件を追加実装するか、別の方式と比較するかを判断できます。
Jevboxを導入するかどうかは、自社の文書と権限を使った試験結果に基づいて決めます。