
AI
AIエージェントの
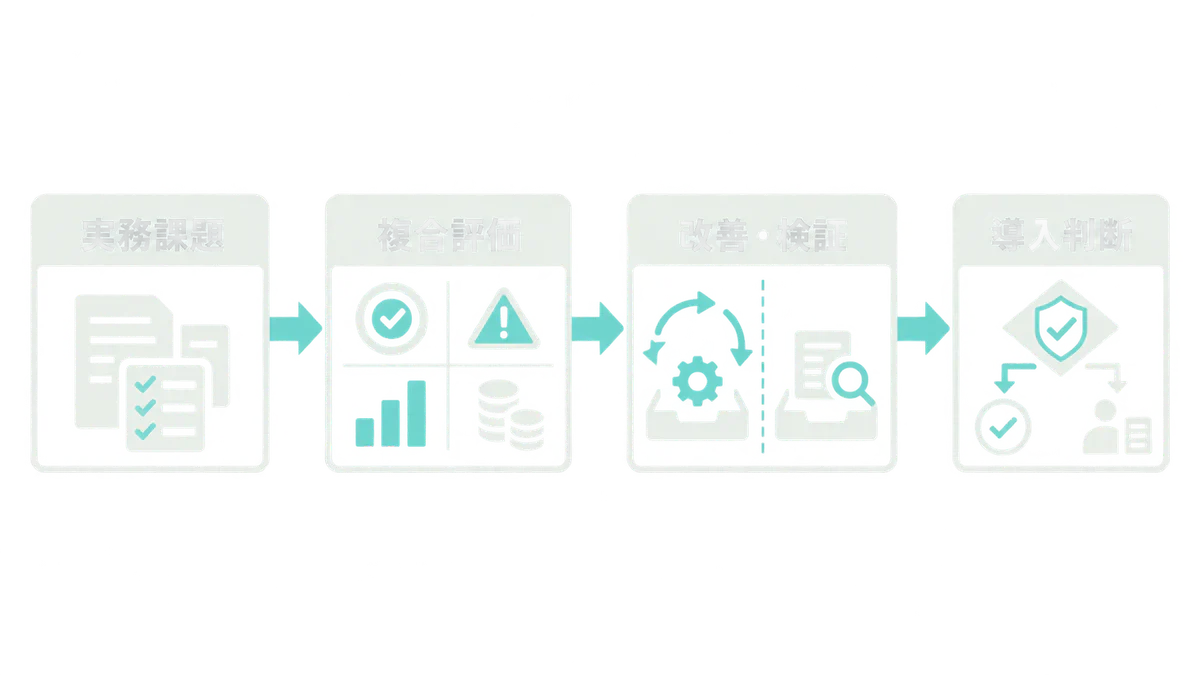
AIエージェントの評価方法を、非技術者の事業責任者向けに解説します。評価データの作り方、採点方法、改善用と検証用のデータの分け方を整理し、品質、費用、重大な失敗を踏まえて本番導入を判断するために、開発チームと合意すべき基準を示します。事業導入前のテスト設計に役立つ入門記事です。
はじめに
AIエージェントの評価では、試作品が数回うまく動いただけでは本番導入を判断できません。 事業責任者と開発チームは、実際の業務を再現した課題を用意し、仕事の完了、品質、費用、重大な失敗を測る必要があります。
AIエージェントは複数の手順を進め、外部の情報や業務システムを利用します。 途中の判断によって最終結果が変わり、同じ依頼に対して異なる結果を返す場合もあります。 そのため、成功した例だけを見ても、業務を任せられるかどうかは分かりません。
評価を始めるときは、少数の重要業務を選びます。 そのうえで、改善に使うデータと最終確認に使うデータを分ければ、事業責任者は共通の基準で本番導入の可否を判断できます。
評価には、開発部門だけでなく業務担当者も参加します。 どの失敗なら人が修正できるのか、何を誤ると顧客や取引に影響するのかは、対象業務を知る担当者が決める必要があるためです。
AIエージェント評価は
AIエージェントの評価では、対象業務を許容できる品質と費用で完了できたかを確かめます。 本番導入を判断する際は、正確さだけでなく、結果の安定性、処理時間、失敗した場合の影響も評価します。
回答が自然でも、業務が正しく完了したとは限りません。 例えば、顧客からの返品依頼を扱うAIエージェントは、丁寧な文章を返しても、返金条件を誤れば不合格です。 社内会議の要約では、表現の違いよりも、決定事項や担当者が欠けていないかを重く見ます。
事業責任者と業務担当者は、業務上の結果に結び付けて評価項目を定めます。
| 評価項目 | 確認する内容 | 事業上の意味 |
|---|---|---|
| 完了品質 | 必要な処理や回答を終えたか | 人による手直しと顧客対応の負担 |
| 重大な失敗 | 誤送信、権限外の操作、根拠のない回答がないか | 損失、信用低下、法務対応のリスク |
| 一貫性 | 同種の依頼で結果が大きく変わらないか | 業務手順として任せられる範囲 |
| 時間と費用 | 所要時間、AI利用料、人の確認時間 | 導入後の採算と処理能力 |
一貫性は、一度の成功だけでは判断できません。 AnthropicのAIエージェント評価ガイド↗は、入力と成功条件を定めた一つの課題をtask、一回の実行をtrialと整理しています。 出力が変わる業務では、一つの課題を複数回試し、各回の結果を確認します。
評価データは
評価データは、利用頻度が高い業務と、失敗した場合の影響が大きい業務から作ります。 この二つを優先することで、本番で任せたい業務と、事故を避けたい業務の両方を評価できます。
業務担当者は、問い合わせ履歴、手作業で確認している例、過去の不具合から評価ケースを選びます。 実務に基づく例を使うことで、実際には起こらない架空の問題に偏るのを避けられます。
一つの評価ケースには、少なくとも次の情報を入れます。
- 入力:顧客の依頼、参照資料、利用できる業務システム
- 期待する結果:更新されるべき状態、回答に含めるべき事項
- 禁止する結果:権限外の操作、情報漏えい、根拠のない確約
- 合格条件:担当者による判定の差を抑えられる具体的な基準
正常な依頼だけを集めても、人へ引き継ぐべき条件は確認できません。 情報が足りない依頼、複数の意図を含む依頼、例外規定に触れる依頼も評価ケースに含めます。
運用を始めた後も、担当者は評価データを更新します。 OpenAIの評価データ作成ガイド↗では、新しく見つかった例外や見落としをデータに加える方法が案内されています。
ただし、評価データの件数を増やすだけでは、判断材料は充実しません。 自社の利用場面と、損失の大きい失敗をどこまで含んでいるかを確認します。
採点方法の
開発チームは、機械的に確認できる条件を先に定め、主観を伴う品質だけを人や別のAIに判定させます。 評価ケースをそろえても、合否の決め方が曖昧であれば、採点者によって結果が変わるためです。
出力を判定する仕組みをgrader(採点器)と呼びます。 業務の性質に応じて複数の採点方法を使い分けると、一つの方法に偏った誤判定を見つけやすくなります。
| 採点方法 | 向いている確認 | 注意点 |
|---|---|---|
| ルールやプログラム | 必須項目、計算結果、データ更新、禁止操作 | 正しい表現の違いまで不合格にしない |
| 別のAIによる判定 | 分かりやすさ、根拠との整合、会話品質 | 判定の揺れや偏りを人が点検する |
| 業務担当者の確認 | 専門判断、重大事故、顧客への影響 | 時間と費用がかかるため対象を絞る |
ルールやプログラムは、条件に合っているかを速く確認できます。 ただし、業務上の妥当性まで自動で判定できるとは限りません。 別のAIによる採点も、業務担当者の判断に代わる基準にはなりません。
OpenAIのgrader設計指針↗は、採点基準をすり抜けて高得点を得る状態への対策と、偏った評価データを避ける必要性を挙げています。 別のAIに採点させる場合は、業務担当者が先に良い例と悪い例を判定します。 その後も、開発チームはAIの採点と担当者の判断が一致するかを定期的に確かめます。
改善用データと
改善に使った課題だけで評価すると、開発チームは、その課題に合わせた調整が全体にも通用する改善だと判断するおそれがあります。 同じ課題の採点結果が上がっても、未知の課題を処理する能力まで上がったとは限りません。
この誤認を避けるため、調整に使う改善用データと、開発中には見ない検証用データを分けます。 一般にtrain/test分割と呼ばれる考え方ですが、ここでの「train」は、必ずしもAIモデル自体の学習を意味しません。 指示文、利用する資料、処理手順の改善に使う課題群と、変更後の実力を確かめる未使用の課題群を分けます。
開発チームは、次の順序で評価します。
- 改善用データで失敗原因を調べる
- 指示、参照情報、処理手順のいずれかを変更する
- 改善用データで意図した修正を確認する
- 検証用データで未知のケースにも効果が及ぶか確かめる
- すでに合格していた業務が悪化していないか再確認する
検証用データの独立性は、確認する担当者と時期を決めて保ちます。 開発担当者が検証用データの結果を見ながら何度も調整すると、そのデータは実質的に改善用になるためです。
事業責任者と開発チームは、新しい失敗例も定期的に追加します。 これにより、特定の検証用データに合わせた調整を防ぎます。
本番導入は
事業責任者は、重大な失敗の有無、人が確認する範囲、処理一件当たりの総費用を合わせて本番導入を判断します。 検証用データの平均点が高くても、発生頻度は低いものの大きな損失につながる誤操作が残っている場合があるため、平均点だけでは導入を決められません。
事業責任者と開発チームは、次の四点を導入前に決めます。
- 必ず満たす合格条件と、改善を続けながら許容する条件
- AIエージェントが処理を止め、人へ引き継ぐ条件
- AI利用料に確認作業と保守を加えた総費用
- 導入後に記録する失敗、処理時間、利用者からの指摘
評価環境で再現できる本番の利用者や入力には限りがあります。 NISTの生成AI向けリスク管理プロファイル↗も、設計、開発、利用、評価を通じて信頼性を扱う任意の枠組みを提供しています。
したがって、自動評価の結果だけで安全性を判断するのは不十分です。 導入後も、開発チームと業務担当者が本番環境を監視し、利用者からの報告と定期的な確認を評価に反映します。
まとめ
AIエージェントの評価では、実務を模した課題を、許容できる条件で繰り返し完了できるかを確かめます。 測定する項目は、完了品質、重大な失敗、安定性、時間と費用です。
事業責任者は、成功条件と許容できない失敗を定めます。 開発チームは、その条件を再現可能な評価方法に落とし込みます。 これにより、両者は本番導入の可否と改善の優先順位を共通の基準で判断できます。
最初から大規模な評価基盤を用意する必要はありません。 まず候補業務を一つ選び、実例と失敗例から小さな評価データを作ります。 進め方には、既存の試作品に検証用データを追加する方法と、外部の専門家と評価基準を整理する方法があります。
事業責任者が決めるのは、自社で最も避けたい失敗と、人が確認できる範囲です。 この二つを基に、開発チームが試験導入の合格条件と中止条件を具体化します。