
AI
自己改善型AIエージェントの作り方|失敗を防ぐ設計・評価・運用
自己改善型AIエージェントを業務へ導入するための設計、評価、運用を解説します。対象業務の選び方、フィードバックの蓄積、人による承認、誤った改善を防ぐ仕組みを整理しました。AIや開発の専任者がいない企業でも、費用対効果とリスクを比較し、小さく試すための判断基準がわかります。
はじめに
AIエージェントを導入しても、担当者が毎回同じ説明を入力し、同じ誤りを直しているなら、負担は十分に減りません。 回答速度だけでなく、修正作業の減少も確認します。
問い合わせ対応、文書確認、社内調査などでは、人が加えた修正を次の処理へ反映できるかどうかで運用コストが変わります。 とはいえ、担当者の修正をすべて取り込めばよいわけではありません。 一人の好みや特殊な事情まで全社のルールにすると、別の案件で品質が下がるからです。
利用者の修正や評価を蓄積し、承認された内容だけを次回以降の作業ルールへ反映する仕組みが、自己改善型AIエージェントです。 導入前に、改善とみなす条件、変更の承認者、更新後の評価方法を決めておきます。
AIや開発の専任者がいない企業では、モデルの性能だけで導入の可否を判断できません。 改善を続けられる業務と運用体制を選べるかどうかが判断基準になります。
自己改善型AIエージェントでは業務ルールを更新する
自己改善と聞くと、AIモデルそのものが学習して賢くなる姿を想像するかもしれません。 しかし、業務で改善しやすいのは、エージェントが参照する手順、判断基準、例外条件です。 人の指摘をそのまま学習させるのではなく、繰り返し使える業務ルールへ変換します。
たとえば、見積書の確認を任せた際に、担当者が「値引率だけでなく支払条件も確認する」と修正したとします。 通常のチャットでは会話が終わるため、次回も同じ指摘を入力することになりかねません。 自己改善の仕組みでは、この指摘を変更候補として保存し、承認を経て確認手順へ加えます。
手順や社内知識は、必要な場面で読み込める単位にまとめられます。 この再利用可能な単位が、Agent Skillsです。 Anthropicの公式文書では、Skillを指示、メタデータ、必要に応じたスクリプトや資料をまとめたものと説明しています。 Claude PlatformのAgent Skills解説↗によると、会話ごとの一時的な指示と異なり、必要な場面で読み込める点が特徴です。
ただし、保存できる情報をすべて「Skill」へ入れるわけではありません。 顧客名や直近の会話履歴を保存するメモリは、個別案件の情報を引き継ぐために使います。 両者を混同すると、一人の担当者にしか当てはまらない要望が全社ルールへ入るおそれがあります。
| 保存する内容 | 適した保存先 | 例 |
|---|---|---|
| 繰り返し使う手順 | Skill | 契約書では解約条件を確認する |
| 個別案件の情報 | メモリや業務データ | A社の更新日は10月末 |
| 一時的な依頼 | 会話内の指示 | 今回だけ表形式で出力する |
見積書の例で「Skill」に残すのは、支払条件も確認するという共通手順です。 特定の案件情報は残しません。 保存先を分ければ、自己改善を適用する範囲を制限できます。
AIエージェントのフィードバックループには承認を挟む
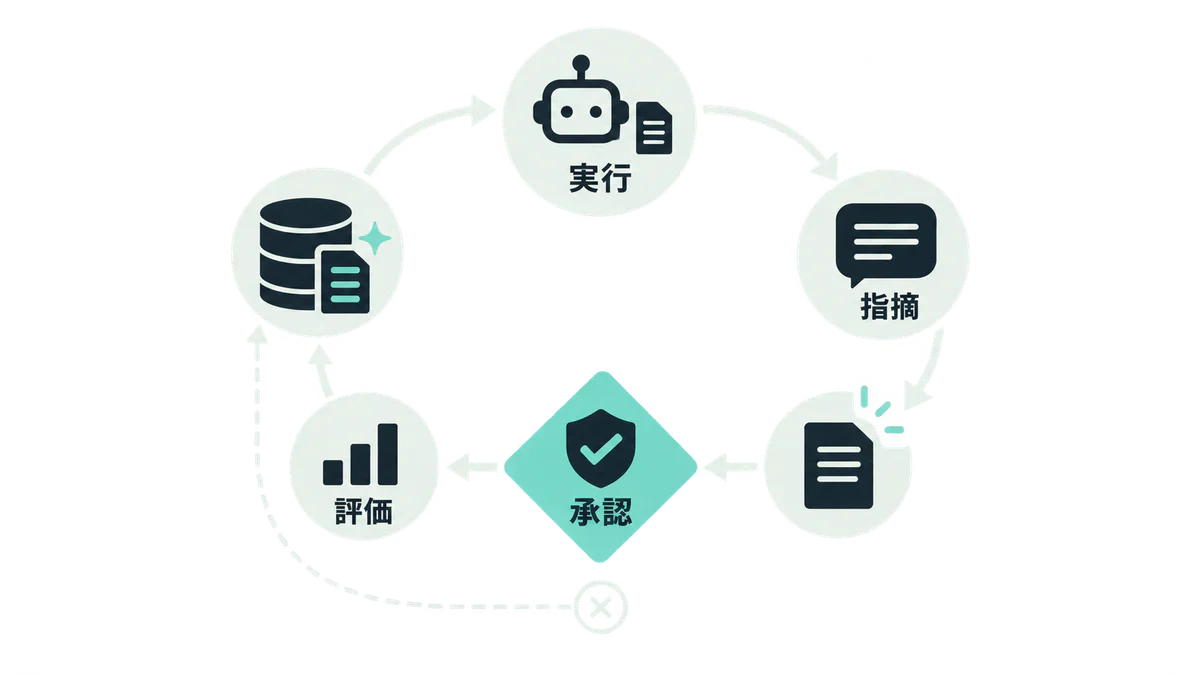
実行結果への評価を集め、次の処理へ反映する循環をフィードバックループと呼びます。 このループでは、変更案を本番ルールへ直接反映させません。 承認前に反映すると、誤った修正まで後続の処理へ広がるからです。
実行から評価までを、次の5段階に分けます。
- AIエージェントが、承認済みの手順に従って業務を処理する
- 担当者が、採用、修正、差し戻しと理由を記録する
- 改善用の処理が、複数の記録から変更案を作る
- 業務責任者が、適用範囲と影響を確認して承認する
- 担当者が、更新前後を同じ評価課題で比較し、悪化していれば以前の版へ戻す
Anthropicが紹介するWarpの取り組みでも、人のフィードバックを収集し、「Skill」の更新へ変換する改善ループを扱っています。 例として挙げられているのはPRレビューやソーシャルリスニングですが、同じ考え方は問い合わせ分類や文書確認にも応用できます。 AnthropicのWarp事例ページ↗では、フィードバックのうち何を学び、何を無視するかも評価項目に含めています。
実行用の手順と改善用の処理を分ければ、AIエージェントが自ら評価基準を書き換えるのを防ぎやすくなります。 変更履歴が残っていれば、品質が落ちたときに原因を調べ、以前の版へ戻せます。
変更案をいったん保留し、更新前後を比較したうえで、問題があれば戻せる運用が必要です。
導入後は速さと品質を分けて測る
自己改善型AIエージェントの導入後は、同じ指摘を繰り返す時間が減ったか、担当者の知見を共通手順として再利用できたかを測ります。 回答回数が増えただけでは、業務が改善したとは判断できません。
問い合わせ対応で担当者が毎回答文を直しているだけなら、修正作業は残ります。 頻出する修正理由を返信ルールへ反映すれば、一次回答の採用率が上がり、例外案件へ時間を割けます。 手戻り、確認時間、見落とし、処理待ち時間がどう変わったかを確認してください。
| 事業上の課題 | 改善後に期待する変化 | 確認する指標 |
|---|---|---|
| 修正作業が多い | 初回出力を採用しやすくなる | 無修正採用率、平均修正時間 |
| 判断が担当者に依存する | 判断基準を共有しやすくなる | 担当者間の判定差、差し戻し理由 |
| 対応が滞留する | 定型案件の処理が早まる | 処理時間、未処理件数 |
| 品質事故が不安 | 高リスク案件を人へ戻せる | 誤処理件数、人への引き継ぎ率 |
無修正採用率が上がっても、誤処理件数が増えたなら改善とは判断できません。 速さと品質を分けずに測ると、業務上の損失を把握できなくなります。
株式会社atypicalでは、Slack上のAIエージェントが質問を通じて要件や改善内容を整理するAIエージェント開発支援を提供しています。 現場の回答を仕様や優先順位へ変換し、改善作業へつなげる支援です。
誤ったフィードバックを避ける承認手順
一度の修正には、共通ルールへ反映すべき知見のほか、担当者の好みや特殊な事情も含まれます。 一件の指摘だけで全体ルールを変えると、別の案件で品質が下がるおそれがあります。
フィードバックは即時に採用せず、出所、適用範囲、再現性、業務リスクを確認します。 改善案には、少なくとも次の情報を添えます。
- 元になった指摘と対象業務
- 同じ問題が発生した件数
- 変更する手順と適用範囲
- 想定される副作用
- 承認者と承認日
- 元に戻す条件
この記録があれば、「誰かが修正した」という事実と、「全案件へ適用できる」という判断を分けられます。 金額、契約、個人情報、対外発信に関わる変更では、業務責任者が承認記録を残すべきです。
NISTのAI Risk Management Frameworkでは、人とAIの役割、監督方法、リスク許容度を文書化し、担当者が運用中も性能を監視するという考え方を採用しています。 NIST AI RMF Core↗は、経営層が導入リスクの意思決定に責任を持つことや、人による監督の手順を定めることも求めています。
失敗時の影響が大きい処理には、人の承認を組み込む場合があります。 この運用をHuman in the Loopと呼びます。 ただし、「Human in the Loop」は、すべての出力を人が確認する運用を指すものではありません。 低リスクの定型処理は自動化し、高額取引、規程の例外、社外公開などを承認対象にします。 すべてを確認すると人の確認時間が増え、自動化の効果も薄れるからです。
人が介入する範囲は、処理件数ではなく、失敗時の影響を基準に決めます。
AIエージェントの評価は更新前後を同じ条件で比べる
更新後の回答が以前より自然に見えても、それだけでは改善したと判断できません。 過去の代表的な案件を評価課題として固定し、更新前後を同じ条件で比較します。
AIエージェントは複数の手順と外部ツールを使うため、途中の小さな誤りが後続処理へ影響します。 AnthropicのAIエージェント評価ガイド↗は、実際の環境に近い課題を用意し、結果と処理経路の両方を確認する必要があると説明しています。
初期の評価で、最初から大規模な評価基盤を作る必要はありません。 実案件から正常例、例外、失敗時の影響が大きい例を選び、20〜50件程度の小さな評価セットから始める方法があります。 この件数は一般的な基準ではなく、初期検証に用いる実務上の目安です。
評価項目は業務目的に合わせます。
- 品質は、必要事項を満たしたか、禁止事項に触れていないかで測る
- 時間は、処理と人の確認に何分かかったかで測る
- 手戻りは、修正や再実行が何回発生したかで測る
- 安全性は、人へ戻すべき案件を正しく判定したかで測る
- 費用は、1件当たりの利用料と運用工数がいくらかで測る
平均点が上がっても、重大な誤りが増えたなら更新は採用できません。 正答率、人が修正する時間、業務上の損失につながる誤りを分けて測ります。
平均的な使いやすさが改善する一方で、失敗時の損失が拡大する場合もあります。 更新を承認する担当者は、両方の結果を見て採否を決めます。
初期導入は低リスクの一業務に絞る
初期導入には、頻度が高く、担当者が正解条件を説明でき、失敗しても人が修正できる業務が向いています。 対象を広げすぎると業務や評価指標が混在し、何が改善し、何が悪化したのかを判別しにくくなります。
売上や契約をAIエージェントだけで確定する業務より、下書き、分類、確認支援から始めるほうが評価しやすくなります。
| 判断基準 | 向いている状態 | 見送る状態 |
|---|---|---|
| 頻度 | 毎週または毎日発生する | 年に数回しかない |
| 判定基準 | 良否を担当者が説明できる | 人によって正解が大きく異なる |
| データ | 過去の処理例と修正履歴がある | 個人情報の管理方法が未定 |
| 失敗時の影響 | 公開前に人が直せる | 即座に契約や送金が確定する |
試行では、一つの業務、一つのチーム、一つの評価指標に範囲を絞ります。 「問い合わせ返信を自動化する」では対象が広すぎますが、「配送状況に関する返信案を作り、無修正採用率を測る」なら更新前後の結果を比較できます。 対象を絞る目的は、改善の有無を判定できる状態に保つことです。
継続の判断日も先に決めておきます。 試行後に、削減できた確認時間、増えた運用工数、重大な誤りの有無を並べれば、担当者は拡大、修正、停止のいずれかを選べます。
まとめ
自己改善型AIエージェントは、人の修正を無条件には取り込みません。 承認済みの知見を再利用可能な業務手順へ変え、同じ評価課題で更新前後を比較します。
導入前には、次の条件を確認します。
- 繰り返し発生し、手戻りを測れる業務か
- 改善案を承認する業務責任者がいるか
- 更新前後を比較する評価課題があるか
- 重大な案件を人へ戻せるか
- 問題が起きたときに以前の手順へ戻せるか
条件がそろっているなら、低リスクの一業務に絞り、時間、品質、費用を測る試行を始められます。 不足している場合は、まず過去の修正理由を記録し、担当者の判断基準を整理します。 毎回繰り返している指摘を集めれば、自己改善型AIエージェントに反映する業務手順の候補を抽出できます。