
AI
LLM A/Bテストの事前評価方法|仮想顧客の作成と予測の限界
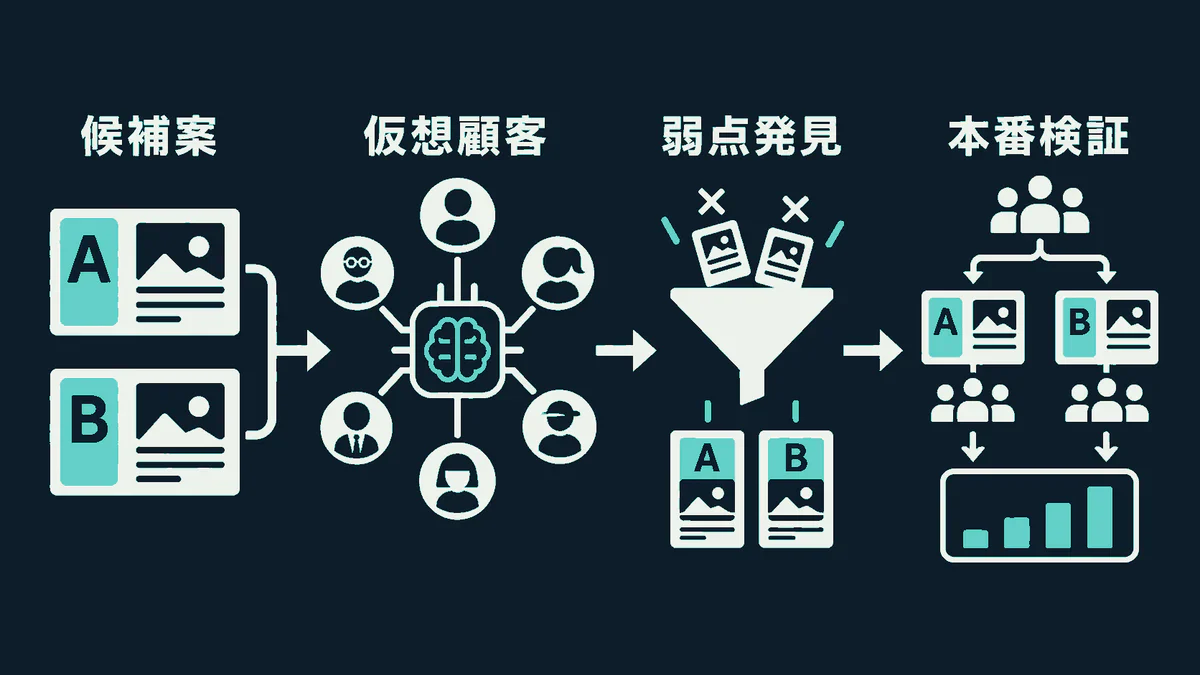
LLM A/Bテストの事前評価で、広告文や画面案を本番前に絞り込む方法を解説します。仮想顧客の作り方、適した検証、結果の読み方、本番実験との使い分けを整理します。導入前に確認したい費用、データ、運用上の判断基準と、予測値を過信しないための注意点も紹介します。
はじめに
複数の広告文や画面案がある場合、本番のA/Bテストへ進める案を絞る必要があります。 候補が多いと検証が分散しますが、担当者の感覚だけで減らせば、有望な案を落とすおそれがあります。
そこで、企画やマーケティングの担当者は、LLM A/Bテストの事前評価を候補の絞り込みに使えます。 ただし、購入率やクリック率を正確に予測する用途には向きません。 導入時には、案の作成、社内レビュー、制作、実装のうち、どの工程を短縮できるかを検討します。
具体的には、担当者が顧客の条件をLLMに与え、各案を評価させます。 すると、訴求の誤解、購入をためらう理由、顧客層による反応の違いを実装前に確認できます。 事前評価の目的は、本番で確かめる候補と論点を絞ることです。
LLM A/Bテストは施策案の初期選別に使う
LLMは、施策案の初期選別と評価理由の整理に使えます。 とくに、広告文、メール件名、商品説明など、言葉の違いを比べる検証に向いています。
たとえば、法人向けサービスの申込ページで、導入の速さを訴えるA案と、運用負担の軽さを訴えるB案を比べるとします。 担当者は、業種、役職、現在の課題、検討段階を設定し、LLMに理解した内容、魅力、懸念、選択理由を答えさせます。 この回答役を仮想顧客と呼びます。
事前評価では、投票数だけで判断せず、次の点を確認します。
- 訴求が想定どおり理解されたか
- どの表現が誤解や不信を招いたか
- 顧客条件を変えても同じ評価になるか
- 判断理由が実際の商品仕様や購買過程と合っているか
仮想顧客が人間を忠実に再現するとは限りません。 比較案を異なる条件から点検し、本番で検証する仮説を作るための回答役です。 LLMが出した架空の支持率を市場予測として扱えば、用途を取り違えることになります。
仮想顧客の回答だけでは行動を予測できない
仮想顧客がもっともらしい選択理由を示しても、実際の顧客行動を予測できたとは判断できません。 現時点では、仮想顧客が示した結果の方向や大きさを、そのまま採用できる段階にはありません。 研究ごとに結果が異なるため、導入する企業が自社の条件で妥当性を確かめる必要があります。
Amazonの研究者は、過去に実施された67件のマーケティングA/Bテストを使い、AIエージェントによる模擬実験を検証しました。 基礎的な方法には効果を実際より大きく見積もる傾向があり、勝敗の向きは約70%一致しました。
この数字だけを見れば、「7割当たる」と解釈する余地があります。 しかし研究者は、単純な基準や元の実験に含まれる不確実性まで考慮すると、方向を予測できた明確な証拠とはいえないと結論づけています。 Amazon Scienceの模擬A/Bテスト研究↗は、校正していない予測を採用できないことを示す資料として読む必要があります。
別の研究では、Upworthyが公開した1万7,681件の見出し実験を使い、LLMに反応のよい見出しを選ばせています。 プロンプトだけで選ぶ方法は振るわず、埋め込みモデルや追加学習したモデルも、無作為な予測をわずかに上回る程度でした。 LOLAの研究論文↗では、研究者がLLMの予測と実際の閲覧者への配信を組み合わせ、反応を見ながら配分を変えています。
流暢な理由は、実際の行動を正しく予測した証拠にはなりません。 担当者は、理由の発見と行動率の予測を分けて扱う必要があります。
仮想顧客は言葉で比べられる検証に向く
仮想顧客は、回答内に評価対象を提示でき、案の違いを言葉で説明しやすい検証に向いています。 実際の操作感や長期利用が結果を左右する検証には向きません。
| 検証対象 | 適性 | 事前評価で確認する内容 |
|---|---|---|
| 見出し、広告文、メール件名 | 高い | 意味の伝わり方、魅力、誤解 |
| 価値提案、料金説明、FAQ | 高い | 理解不足、懸念、判断材料の欠落 |
| 静止画を含む画面案 | 中程度 | 第一印象、情報の見つけやすさ |
| 複雑な操作手順 | 低い | 実際の迷いや操作時間を再現しにくい |
| 購入率、継続率の数値予測 | 低い | 流入経路や競合状況などを再現できない |
用途を品質検査に絞ると、LLMの評価結果を扱いやすくなります。 AmazonのMarketingFMでは、担当者が生成した広告文を公開前に人とLLMで評価しています。 関連性などの基準を満たさない案を除外してから、オンラインA/Bテストを実施する仕組みです。 LLMと人の評価が89.57%一致したと報告されていますが、研究者が測ったのは広告品質の判定であり、クリック率の予測精度ではありません。
この運用でも、研究者は、基準値の設定や本格導入前の検証には人の監督が必要だとしています。 MarketingFMの研究概要↗を踏まえると、公開できない案を早めに除く用途から始めるほうが、運用方法を決めやすくなります。
仮想顧客は実データから作り、同じ条件で比べる
評価に使える仮想顧客を作るには、属性を細かく並べるだけでは足りません。 担当者は、実際の顧客情報から評価に関係する条件を抽出し、すべての案を同じ手順で比べられるようにします。 年齢や性別よりも、課題、検討段階、選定基準、利用上の制約を明確にします。
実務では、次の順序で進めると比較条件を保ちやすくなります。
- 判断目的を一つに絞る
勝つ案の予測ではなく、誤解の多い案を除く、本番へ進める2案を選ぶなど、事前評価の役割を決めます。 - 顧客条件を実データから作る
顧客インタビュー、営業記録、問い合わせ、アクセス解析から、課題と選定基準を抽出します。 評価に不要な氏名や連絡先は使いません。 - 比較対象以外の条件を揃える
A案とB案の価格、商品情報、回答形式が、意図せず変わらないようにします。 提示順も入れ替えます。 - 評価項目を固定する
理解した内容、魅力、懸念、選択、確信度、選択理由を同じ形式で答えさせます。 - 条件を変えて繰り返す
顧客層、提示順、指示文を変えても結論が変わらないかを調べます。 一度の回答だけでは判断しません。 - 人が根拠を点検する
存在しない仕様への言及、一般論だけの理由、顧客条件との矛盾を除きます。 残った論点を本番テストの仮説にします。
評価結果は勝敗表だけにせず、判断の根拠を確認できる形でまとめます。
| 観察された結果 | 実務上の判断 |
|---|---|
| 複数の顧客条件で同じ誤解が出た | コピー修正や説明追加を検討する |
| 特定の顧客層だけが別案を選んだ | 顧客層別の本番テストを検討する |
| 提示順を変えると選択が逆転した | 案の差が弱い可能性を疑う |
| 商品情報にない理由が頻出した | 回答を採用せず、入力条件を見直す |
複数の顧客条件で同じ誤解が出た場合は、支持率よりも、その誤解を修正するかどうかを検討します。 提示順だけで選択が逆転した場合は、案の優劣を断定できるほどの差がない可能性があります。
LLM活用を一度の検証で終わらせず、業務手順やデータの扱いまで整える場合には、atypicalのAI業務改善とFDE支援のように、現場の課題整理から実装、定着までを対象にする進め方もあります。
導入効果は準備工程の変化で測る
仮想顧客を導入しても、担当者は売上への効果を事前に約束できません。 ただし、制作や配信の前に弱い案を除ければ、開発担当者は限られた時間を有力な比較に使えます。 そのため、導入直後は準備工程の変化を測ります。
測定候補は次のとおりです。
- 企画案のレビューにかかった時間
- 制作開始後に発生した修正の回数
- 本番テストへ進めた案の数
- 公開前に見つかった重大な誤解や表現上の問題
- 仮想顧客が挙げた論点と、実際の顧客調査で出た論点の一致
費用を見積もる際は、LLMの利用料に加え、顧客条件の整理、評価結果の確認、指示文の保守、機密情報の管理にかかる人の作業を含めます。 大量の回答を生成しても、担当者が読む時間だけが増えれば、生産性は上がりません。
試行時には、対象を一つの施策に絞り、評価時間の上限と採否基準を先に決めます。
本番A/Bテストと顧客調査で実際の行動を確かめる
顧客調査、仮想顧客、本番実験は、それぞれ答えられる問いが異なります。 LLMの結果は仮説の優先順位づけに使い、実際の顧客行動と施策の効果は本番A/Bテストで確かめます。
| 手段 | 主に答える問い | 得意なこと | 主な限界 |
|---|---|---|---|
| 顧客インタビュー | なぜ困り、どう判断するか | 顧客固有の事情や未知の論点を知る | 発言と実際の行動が一致するとは限らない |
| LLMによる事前評価 | 各案にどんな弱点がありそうか | 多数案の初期点検、理由の整理 | 母集団の代表性や行動率を保証しない |
| 本番A/Bテスト | 変更が指標に差を生むか | 現実の環境で効果を測る | 流量、期間、制作や実装が必要になる |
仮想顧客が挙げた弱点は、本番で検証する候補です。 顧客インタビューでは判断の背景を探り、本番A/Bテストでは現実の環境で生じた差を測ります。
導入を判断する担当者は、次の五点を確認します。
- 比較したい案を文章や画像として提示できるか
- 顧客条件を実際の記録から定義できるか
- 誤判定しても、本番前に人が修正できる用途か
- 成功を予測精度だけでなく、候補削減や手戻り減少で測れるか
- 利用するLLMの契約、データ保存、アクセス権限を確認できるか
これらの条件が揃わない場合は、先に顧客インタビューやアクセス解析を行い、判断材料を増やすほうが適しています。
まとめ
LLM A/Bテストの事前評価は、実装前に候補と論点を絞る手段です。 文章で比較できる施策を対象とし、実際のデータから顧客条件を作ります。 提示順や指示を変え、結果が安定するかも確かめます。 ただし、購入率やクリック率の予測値を本番の測定結果として扱うことはできません。
最初の試行には、結果が判明している過去のA/Bテストを一件使えます。 LLMが勝敗を当てたかだけで判断せず、実際に起きた誤解や顧客層ごとの差を拾えたか、評価に何時間かかったかを確認します。
論点を安定して得られた場合は、新しい施策の候補選定へ広げます。 再現しない場合は、用途を文章の品質検査に限定します。 導入を続けるかどうかは、本番で確かめる案を減らせたかどうかで判断します。